怎么测的
目标页面是英文维基百科的 Transformer 词条——足够长、结构复杂、带大量链接和参考文献,抓取工具的差别在这种页面上最容易暴露。两家都在同一网络下用命令行直接调接口,记录耗时和返回的 Markdown 体量,再逐段比对内容。
- Jina Reader:网址前面加
https://r.jina.ai/就能调,无 Key。 - Firecrawl:注册账号还卡在邮箱验证码(细节见本站注册实测那篇),这次用的是它官方提供的免 Key 层调
/v2/scrape,同样无 Key。
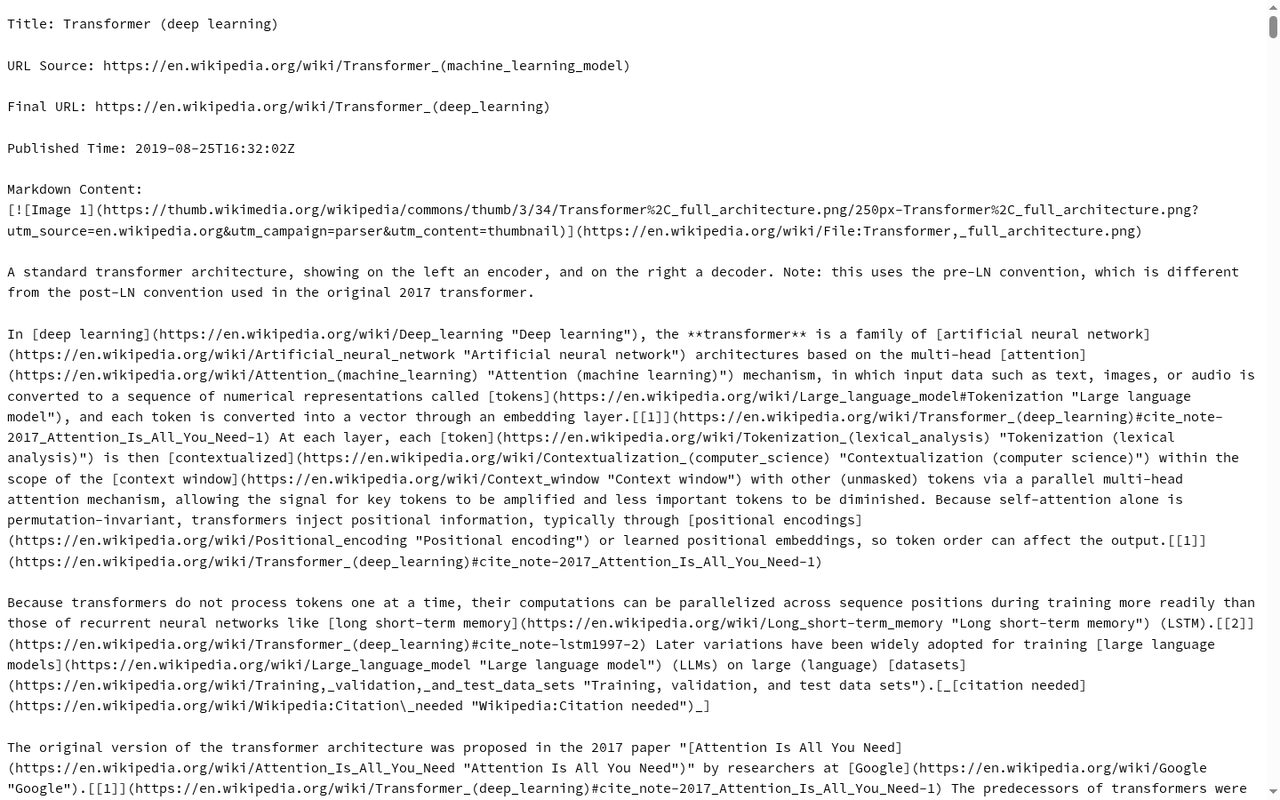
实测截图:Jina Reader 抓英文维基 Transformer 词条的返回开头——标题和来源之后直接是正文,没有页脚噪音,2026-11-14
成绩单
| Jina Reader | Firecrawl(免 Key) | |
|---|---|---|
| 耗时 | 5.1 秒 | 14.3 秒 |
| 返回字符 | 135,305 | 206,605 |
| 行数 | 612 | 814 |
| 文内链接 | 806 | 1,466 |
| 图片 | 19 | 28 |
Firecrawl 慢了近三倍,多返回了 7 万多字符。多出来的不是正文:开头是「Jump to content」这类页面跳转链接和词条维护横幅,中间多收了表格和图注,结尾整段是维基的页脚——搜索框、「37 languages」语言列表、分类链接。Jina 的输出则从标题直接进正文,结尾停在参考文献条目,没有页脚噪音。
换句话说,两家抓到的正文一样不少(关键章节如 Vision transformer 都在),差别在「顺手多带了多少页面零件」。这 7 万字符喂给模型是要按 token 花钱(或花免费额度)的,噪音就是成本。
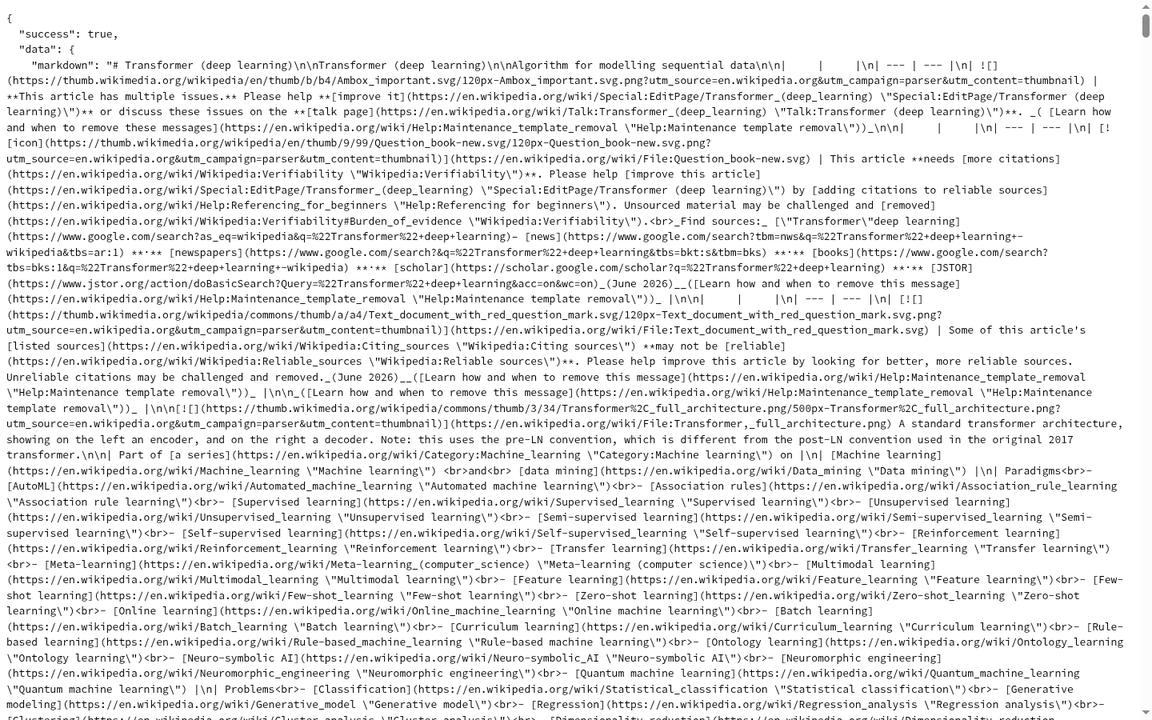
实测截图:Firecrawl 免 Key 层抓同一词条的返回开头——正文还没开始,先是一串词条维护横幅和侧栏链接,多出来的字符长这样,2026-11-14
中文页补测
又用 Jina 抓了中文维基的 Transformer 词条:3.7 秒,44,660 字节,中文输出、图注和章节都正常。日常抓中文长文,Jina 这一条路够用。
各自的门槛在哪
Jina 的门槛在频率:无 Key 限速 20 RPM,偶尔抓几篇没问题,高频批量就得注册拿 Key——每个新 Key 送 1,000 万免费 token,限非商用。它的好处是注册之前就能先把活干了,验证完效果再决定要不要注册。
Firecrawl 的门槛在账号:免费档每月 1,000 credits 不绑卡,但注册最后一步要邮箱里的 6 位验证码确认(本站实测就停在这一步,验证码确认完才能建 Key)。等不及的话,官方免 Key 层能先顶上,就是限速更严、某些网络会被直接拒绝,别拿它跑批量。
结论怎么用
- 抓正文喂模型、做摘要问答:Jina,快、干净、零门槛。
- 整页存档、要表格和完整元数据:Firecrawl,多花点时间换完整度,先小样试跑看 credits 消耗。
- 两家都别拿去抓需要登录的页面,那不在免费抓取的能力范围内。
相关教程
常见问题
Jina Reader 不注册真能用吗?
能。2026-11-14 实测无 Key 直接调通,限速 20 RPM;高频再注册拿 Key。(最后验证:2026-11-14)
Firecrawl 不注册怎么测的?
用官方免 Key 层调的抓取接口,注册账号当时卡在邮箱验证码确认。免 Key 层限速,批量任务还是要账号。(最后验证:2026-11-14)
抓来的内容喂模型前还要处理吗?
Jina 的基本可以直接喂;Firecrawl 的建议先截掉开头跳转链接和结尾页脚,能省三成左右 token。(最后验证:2026-11-14)