流水线就三步
第一步抓取。用 Jina Reader 无 Key 抓取,网址前加前缀即可,返回现成的 Markdown——这一步为什么选它,见本站的抓取对比实测:快,而且不带页脚噪音,省 token。
第二步截断。全文 13.5 万字符没全塞进去,只取了前 1.2 万字。理由很实际:词条的前半已经覆盖定义、核心机制和主要应用,摘要要的信息密度在前面;全塞既慢又浪费调用量。真要处理全文,应该分段摘要再合并,那是另一套做法。
第三步摘要。把截断文本连同一句中文要求(300 字以内、讲清是什么、核心机制、主要应用,再列 3 个关键点)发给魔搭 API-Inference 的 DeepSeek-V4-Pro-0813。
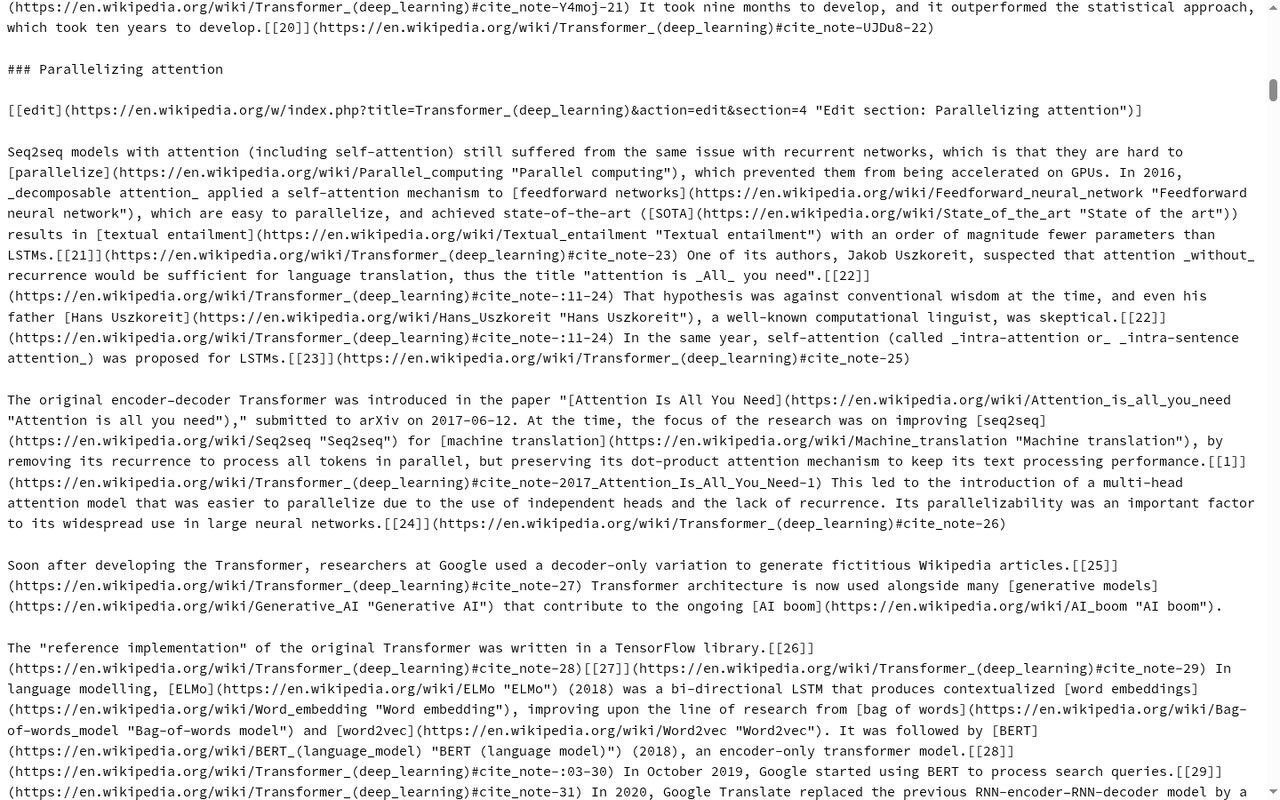
实测截图:Jina 抓回的原文中段(Parallelizing attention 一节)——全文 13.5 万字符,摘要只截了前 1.2 万字,2026-11-14
摘要质量:拿原文核对过
返回的摘要约 285 字,关键事实逐条核对:2017 年 Google《Attention Is All You Need》提出、多头自注意力机制、位置编码补顺序信息、相比 RNN 可并行训练——全部与原文一致,没有编造。3 个关键点也都落在原文范围内。这个质量做日常「先读个大概再决定精不精读」完全够用。
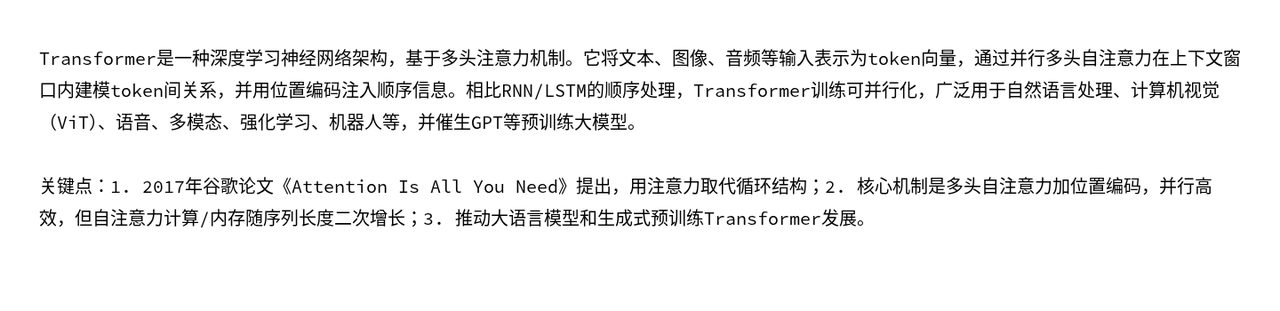
实测截图:魔搭 DeepSeek-V4-Pro-0813 返回的摘要原文(同流水线复跑的输出)——是什么、核心机制、主要应用和 3 个关键点都在,2026-11-14
坑一:模型 ID 在列表里,不等于能调
第一次调用选的是 DeepSeek-V4-Flash-0731——这个 ID 就在魔搭模型列表里躺着,接口却直接返回 400,报错「no provider supported」。换成带日期后缀的 DeepSeek-V4-Pro-0813 才调通。教训:魔搭的模型列表只说明「有这个模型」,能不能走 API 调用得实测,写自动化脚本前先拿目标模型发一条最小请求验通。
坑二:返回的尾巴上拖着模型的自言自语
Pro 这次的返回里,摘要正文之后还跟了一段它自己盘算字数的文字(「第一句约 40,第二句约 80……总共约 285,应该 ok」)。摘要本身没问题,但直接把返回全文贴给用户就会露馅。处理办法:提示词里明确只要正文、或者程序里按标记截取,别原样转发。
额度账
- 魔搭 API-Inference:按魔粒计,不按 token。每天登录领 200 魔粒、绑定阿里云再加 50 魔粒(短期魔粒,发放后 24 小时有效);DeepSeek-V4-Pro 这类旗舰约 2 魔粒/次,一次摘要约 2 魔粒,一天处理几十篇长文没问题,前提是每次输入别长到超时。现行官方使用限制页已不写固定次数和单模型上限,只说并发按平台负载动态调整——排批量活前先看模型页标的「预计魔粒消耗」和自己账号的魔粒余额。
- Jina Reader:无 Key 20 RPM 是抓取那头的天花板;真高频了再注册拿 Key(新 Key 送 1,000 万 token,限非商用)。
- 两边都不绑卡,这条流水线的总成本就是自己的几行脚本。
官方原话(原文照录):"Over 60,000+ models available, with up to 2,000 free daily cumulative calls!"(ModelScope 魔搭官方帖)
注意:上面这句是魔搭官方社区帖的原话,写的是旧口径——官方现行「API-Inference 使用限制」页已经改成魔粒结算(见上),社区帖还没跟着改。两种说法并存,以控制台实际扣量为准。
摘要这一步还能换谁:三家免费来源对比
魔搭挂了或额度用完,摘要这一步可以平移的对象不少,但三家的计费单位完全不同:魔搭按魔粒(本质是按次扣)、智谱按 token(免费模型单价就是 0)、Groq 按次和 token 双限速。选哪家取决于你喂的文本有多长、一天要跑多少篇。
| 来源 | 免费额度 | 计费口径 | 绑卡/门槛 |
|---|---|---|---|
| 魔搭 API-Inference | 每天 250 魔粒(登录 200+绑阿里云 50);轻量约 0.5、主流约 1、旗舰约 2 魔粒/次 | 按魔粒计(按次扣),不按 token | 不绑卡;需注册并绑定阿里云账号 |
| 智谱 GLM | GLM-4.7-Flash 输入、输出免费,上下文 200K | 按 token 计价,该模型单价为免费 | 不绑卡;邮箱注册拿 API Key |
| Groq | 免费档按模型限速:gpt-oss-120b、gpt-oss-20b 为 30 RPM、每天 1,000 次、每天 200K token | 请求数与 token 数双限速,先到先限,超限报 429 | 不绑卡;邮箱注册拿 API Key(本站实测注册曾被反机器人拦,见站内 Groq 教程) |
数字来源,2026-11-15 核对:魔搭 API-Inference 使用限制文档与魔粒激励计划文档(魔粒单价与每日 200+50 的领取数均出自这两页;官方社区帖仍写每天 2,000 次,是旧口径,并存备查)、智谱官方定价页、Groq 官方速率限制页。换算到这条流水线:1.2 万字输入的摘要,魔搭烧约 2 魔粒(旗舰单价)、智谱烧 0 元;Groq 这边一次调用的 token 量不小,一天跑几十篇就会先撞每天 200K token 的上限,而不是 1,000 次的次数上限——长文摘要优先魔搭和智谱,Groq 更适合短文本高频调用。
相关教程
常见问题
全文 13 万字都能一次喂进去吗?
本次实测只喂了前 1.2 万字。全文处理请分段摘要再合并,别指望一次调用解决。
这条流水线要花钱吗?
不要。Jina 无 Key 免费层加魔搭每天登录领取的魔粒抵扣调用,2026-11-14 实测全程零费用。
换别的模型行不行?
行,但魔搭上先验通再用:列表里有的模型可能报 no provider supported,本次实测通的是 DeepSeek-V4-Pro-0813。